Le 15 octobre 2026, l’Institut Français de Bioinformatique (IFB/ELIXIR-FR) a participé au séminaire « From Bench to Bytes: Mastering the Science of Data », organisé par Lesaffre, acteur mondial de la fermentation. Cet événement visait à découvrir, partager et échanger autour de la gestion des données scientifiques, un enjeu croissant à mesure que les volumes de données augmentent, que les formats se multiplient et que les exigences réglementaires se renforcent.
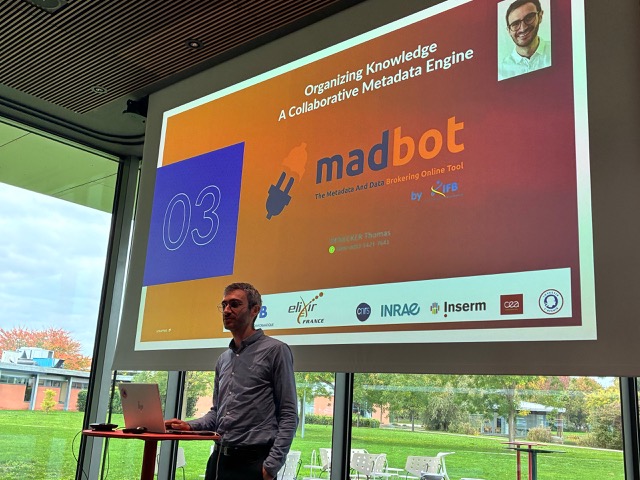
Thomas Denecker (IFB/ELIXIR-FR) – Séminaire Lesaffre – Octobre 2026
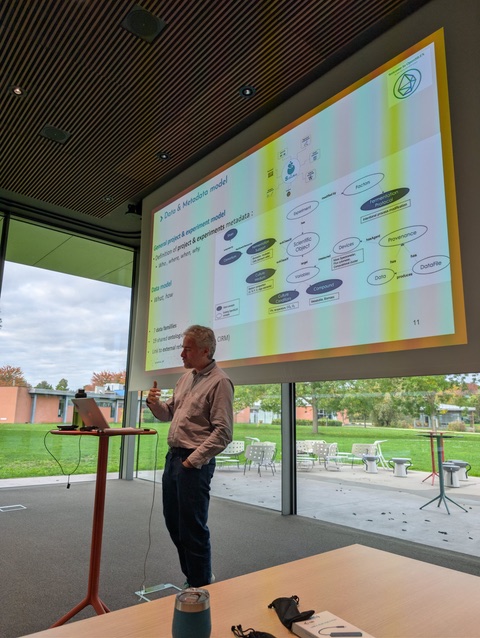
Valentin Loux (Plateforme Migale) – Séminaire Lesaffre – Octobre 2026
À l’invitation de Tiphaine Cussac et de Pierre Mahé, deux représentants de l’IFB sont intervenus aux côtés des équipes de Lesaffre :
- Valentin Loux, responsable technique de Migale, plateforme membre de l’IFB/ELIXIR-FR, a présenté SIDURI, un portail intégré de données et d’analyses au service de l’innovation en fermentation, dans le cadre du partenariat public-privé Ferments du Futur. Titre de son intervention : « SIDURI: an integrated data and analysis portal supporting data-driven innovation in food fermentation ».
- Thomas Denecker, co-responsable de l’action Outils logiciels de l’IFB et co-responsable du projet madbot, a présenté madbot (Metadata And Data Brokering Online Tool), l’outil développé par l’IFB pour aider les chercheurs à organiser, décrire et publier leurs données. En s’appuyant sur les standards internationaux, madbot automatise une grande partie du travail de description des données et facilite leur dépôt dans des entrepôts comme Zenodo ou l’ENA (European Nucleotide Archive).
Les équipes de Lesaffre ont de leur côté partagé leur approche collaborative de la gestion des données, avec Pierre Mahé, directeur de l’équipe BioData, et Clémence Dupas, data steward pour l’industrie, qui a présenté la « Fresque des données », un parcours d’apprentissage à l’échelle de l’entreprise.
Cette journée illustre l’intérêt des outils et des pratiques portés par l’IFB/ELIXIR-FR, notamment autour des principes FAIR, pour répondre aux besoins concrets des acteurs académiques comme industriels, et contribue à construire un écosystème de données plus connecté.